
深度学习之LSTM模型
在前面的博客中,我们已经介绍了基本的RNN模型和GRU深度学习网络,在这篇博客中,我们将介绍LSTM模型,LSTM全称是Long Short-Time Memory,也是RNN模型的一种。
相比较基本的RNN模型和GRU模型,LSTM的模型参数更多。与RNN和GRU类似,LSTM是一种RNN模型,它的输入和RNN与GRU一样,都是前一阶段的状态变量和当前状态的数据,输出的是当前状态的标签和当前状态的状态变量。
为了说明LSTM,我们先看一下基本的RNN结构:
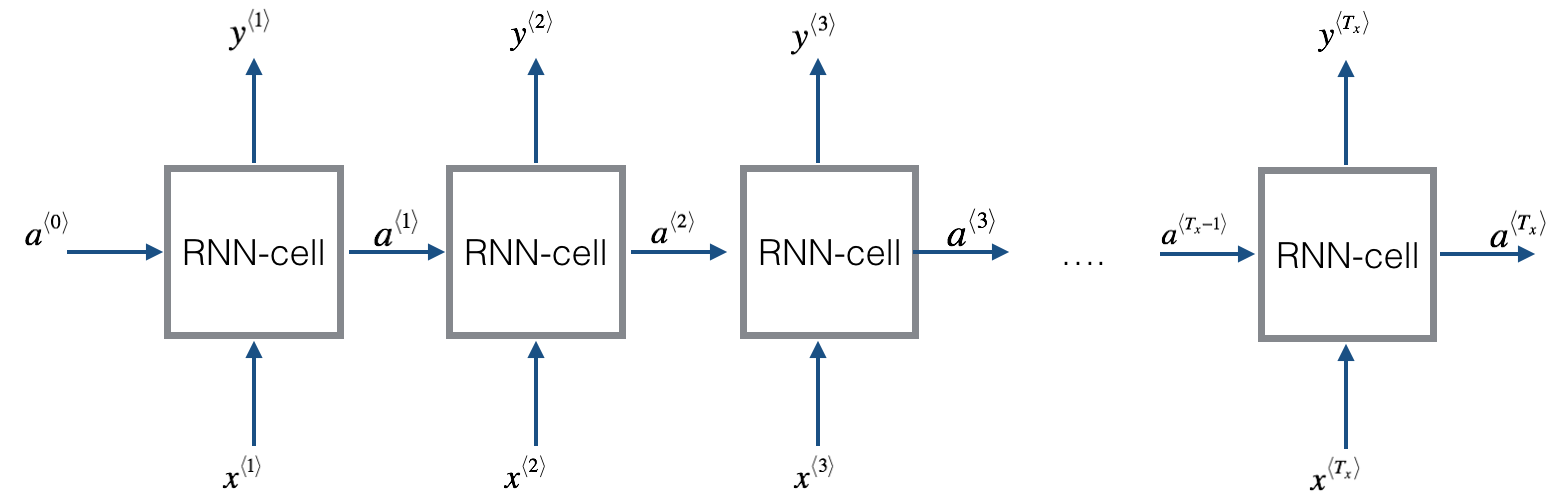
这三种模型的基本结构都是类似的,但是每个模型的CELL内部计算是不同的。其中,
RNN模型中CELL的计算:
a^{< t>} = g(W_a [a^{< t-1>},x^{< t>}] + b_a)
\hat{y}^{< t>} = g(W_y a^{< t>} + b_y)
而GRU网络中CELL的计算如下:
\tilde{c}^{< t>} = \text{tanh}(W_c[\Gamma_r\times c^{< t-1>},x^{< t>}] + b_c)
\Gamma_u = \sigma(W_u[c^{< t-1>},x^{< t>}] + b_u)
\Gamma_r = \sigma(W_r[c^{< t-1>},x^{< t>}] + b_r)
c^{< t>} = \Gamma_u \times \tilde{c}^{< t>}  + (1-\Gamma_u)
 \times c^{< t-1>}
\hat{y}^{< t>} = g(W_y c^{< t>} + b_y)
注意到,GRU的状态变量$c^{< t>}=a^{< t>}$,这两个是一样的。GRU模型中包含了两个门,一个是更新门$\Gamma_u$,一个是重置门$\Gamma_r$,他们共同决定了状态变量是重新计算还是使用前一阶段的结果。
而LSTM模型比GRU参数更多,它包含了三个门,即“更新门”、“遗忘门”和“输出门”,其计算如下:
\tilde{c}^{< t>} = \text{tanh}(W_c[\Gamma_r\times a^{< t-1>},x^{< t>}] + b_c)
\Gamma_u = \sigma(W_u[a^{< t-1>},x^{< t>}] + b_u)
\Gamma_f = \sigma(W_r[a^{< t-1>},x^{< t>}] + b_f)
\Gamma_o = \sigma(W_r[a^{< t-1>},x^{< t>}] + b_o)
c^{< t>} = \Gamma_u \times \tilde{c}^{< t>}  + \Gamma_f
 \times c^{< t-1>}
a^{< t>} = \Gamma_o \times \text{tanh}\space\space c^{< t>}
\hat{y}^{< t>} = g(W_y a^{< t>} + b_y)
可以看到,LSTM多了一个状态变量$c^{< t>}$,GRU中$c^{< t>}=a^{< t>}$,而LSTM中$c^{< t>}$是由更新门$\Gamma_u$和遗忘门$\Gamma_f$决定,它的结果和输出门$\Gamma_o$一起,决定了最终的状态变量的输出。
LSTM的网络示意图如下:
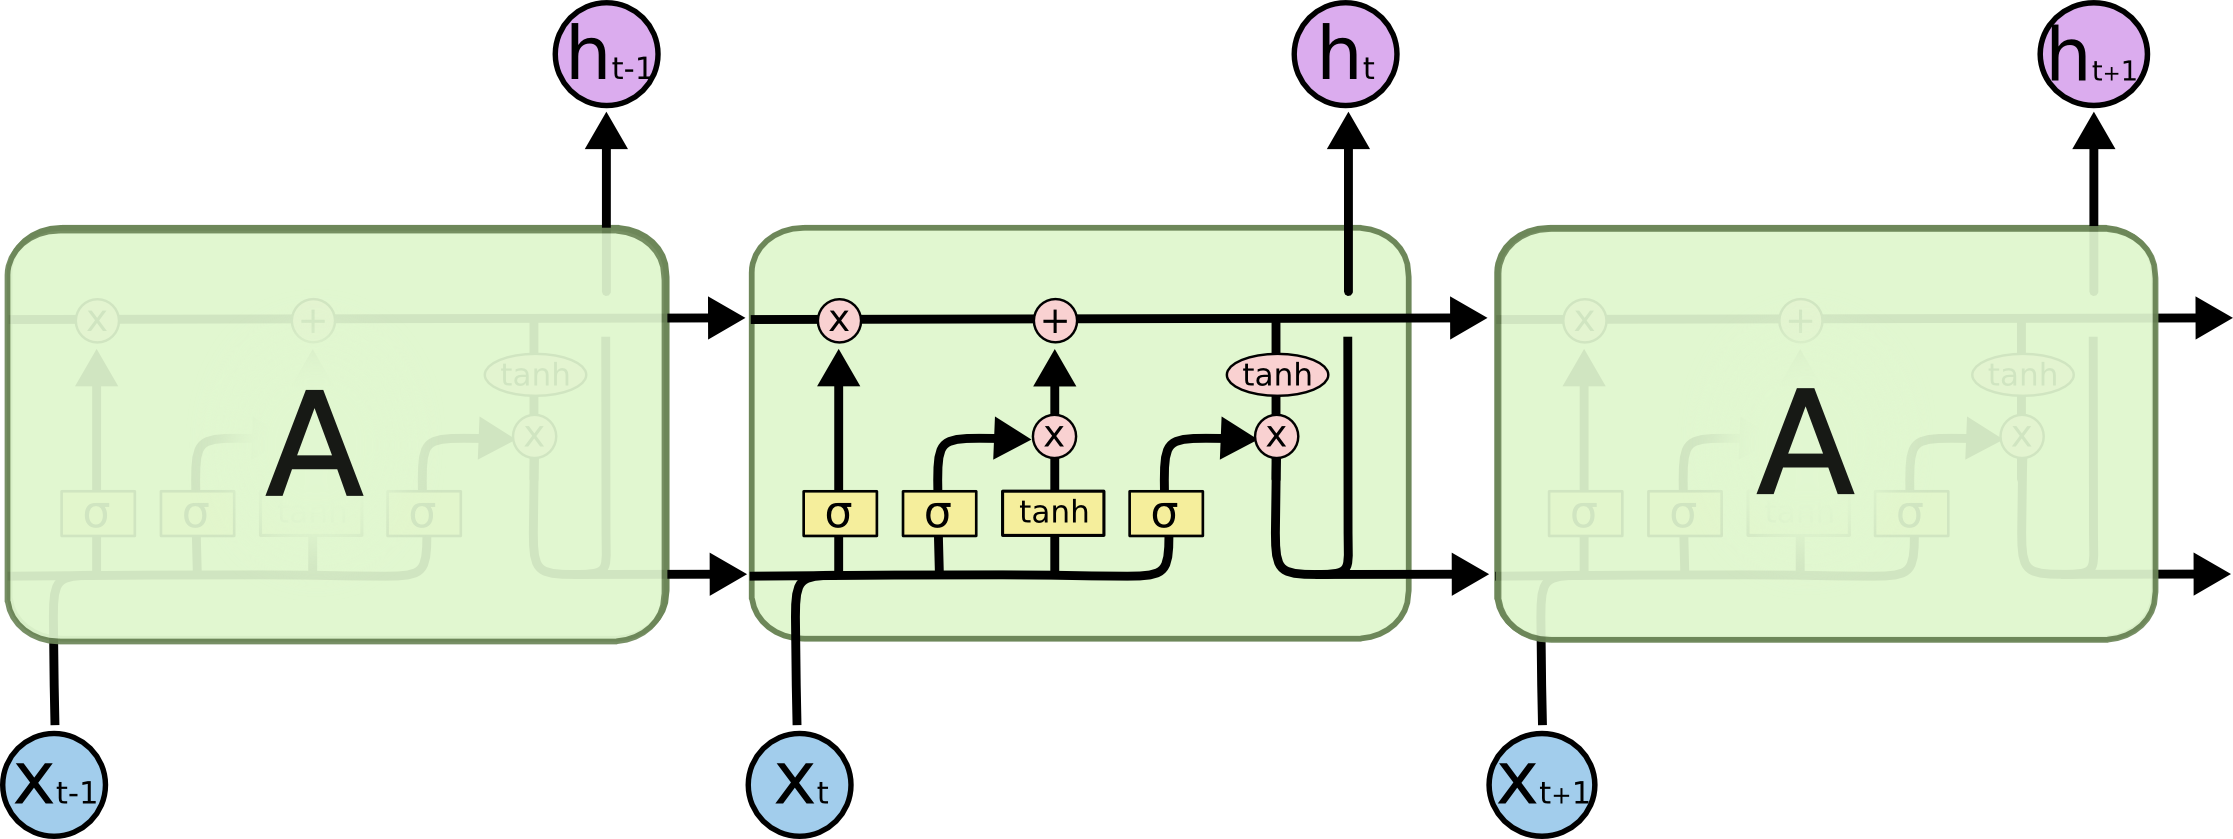
可以看到,LSTM内部的参数更多,因此也更加强大。在深度学习历史中,LSTM模型比GRU出来的更早,GRU是LSTM的一个简化版本。在某些任务中,GRU也取得了和LSTM类似的效果,但是LSTM要更好点。尽管如此,GRU的参数更少,运算速度更快,因此容易构造更大的网络。现实中,首选LSTM模型的人要多一些。
